AI-sökning · Teknisk SEO
Varför din webbplats lyckas i Google men är osynlig för AI
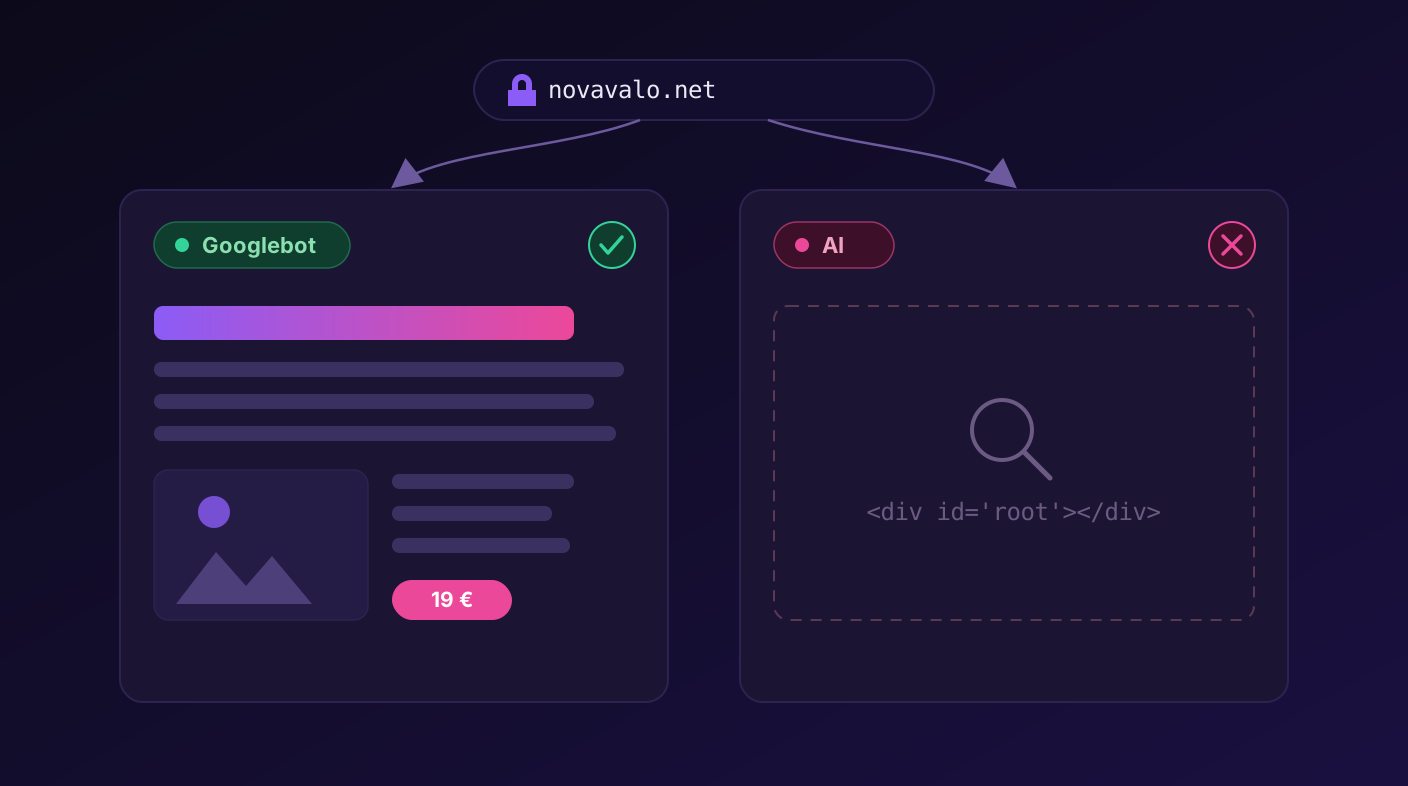
Din webbplats kan ranka högt i Google, få gröna markeringar i SEO-verktyg och ändå vara nästan osynlig för AI-sökning och AI-agenter. ChatGPT, Claude, Perplexity och Gemini ser inte webben på samma sätt som Google. I den här artikeln går vi igenom tre skäl till att AI inte ser din sida, hur du testar saken själv och varför HTML som genereras på servern löser problemet.
Kort sagt: om ditt viktiga innehåll (rubriker, texter, priser, Schema-data) laddas först i webbläsaren med JavaScript ser många AI-botar en tom sida. Detsamma gäller när en brandvägg eller ett CDN blockerar AI-boten. Ditt SEO-verktyg berättar inte nödvändigtvis något om detta.
Google och AI-sökning läser webben på olika sätt. Googlebot renderar JavaScript och tar sig oftast igenom brandväggar. De flesta AI-botar kör inte JavaScript, utan läser bara den råa HTML som servern returnerar, och de kan blockeras redan i brandväggen eller i CDN:et.
Därför kan en webbplats lyckas i Google men förbli osynlig för AI. Vanliga SEO-verktyg märker inte detta, eftersom de främst läser robots.txt-filen och inte det faktiska innehåll som serveras till botarna.
Lösningen är att kritiskt innehåll och Schema-data finns färdiga i den HTML som servern returnerar (SSR eller statisk sida) och att AI-botarna inte är blockerade. Novavalo producerar just sådan statisk HTML, så sidor byggda med Novavalo syns både för Google och för AI.
Olika botar för olika syften
AI-företagen har inte en enda bot utan flera separata botar för olika uppgifter: en samlar material för att träna modellen, en annan bygger ett sökindex och en tredje hämtar sidan just när en användare begär det. Din webbplats kan tillåta den ena och blockera den andra utan att du märker det.
Till exempel kör både OpenAI och Anthropic flera botar. Hos OpenAI samlar GPTBot träningsdata, OAI-SearchBot bygger sökresultat och ChatGPT-User hämtar sidan utifrån en användares begäran i realtid. Hos Anthropic samlar på motsvarande sätt ClaudeBot material, Claude-SearchBot kontrollerar sidor för sökning och Claude-User hämtar sidan när någon frågar Claude om något på den aktuella adressen.
Google är här ett undantag. Det har ingen separat AI-bot på samma sätt, utan den traditionella Googleboten sköter till största delen även bakgrundsarbetet för AI Overview-resultaten och AI-funktionerna. Därför fungerar det som fungerar för Google inte automatiskt för andra AI-aktörer: Google är redan inne, medan separata AI-botar måste släppas in särskilt och måste kunna läsa sidan.
Brandväggar och CDN blockerar botar före robots.txt
Ett skyddslager, som Cloudflare, en WAF-brandvägg eller webbhotellets blockeringsinställningar, kan avvisa AI-boten redan på IP-nivå, innan boten ens hinner läsa robots.txt-filen. Då får boten inte sidan alls, hur bra ditt innehåll än är.
Många CDN- och säkerhetstjänster har börjat blockera kända AI-botar som standard eller med ett enda klick. Det kan vara ett medvetet val, men ofta har det blivit kvar på av misstag eller satts upp av någon annan. Slutresultatet är att en mänsklig besökare och Googlebot kommer in på sidan, men att till exempel ClaudeBot får en blockering som svar.
I ett verkligt exempelfall kom ChatGPT in på webbplatsen, men Anthropics Claude var blockerad i serverns brandvägg. För användaren syns detta så att den ena AI-assistenten kan berätta om företaget och den andra inte hittar något om det. Ett vanligt SEO-verktyg avslöjar inte problemet, eftersom det bara läser robots.txt-filen, där blockeringen inte syns: blockeringen sker på nätverksnivå långt tidigare.
Robots.txt håller inte alltid
En annan överraskande sak är att robots.txt inte är bindande för alla botar. Botar som rör sig på användarens begäran förbigår ofta förbuden. OpenAI har själv konstaterat att eftersom en ChatGPT-User-begäran startas av en människa, gäller robots.txt-reglerna inte nödvändigtvis den.
Detta är inte bara teori. Enligt branschutredningar nådde ChatGPT-User sidor på ungefär hälften av de europeiska webbplatser som uttryckligen hade blockerat den i robots.txt-filen. Den praktiska lärdomen är dubbelriktad: du kan inte lita på att robots.txt blockerar agenter i realtid, och du kan å andra sidan inte anta att enbart ett tillstånd i robots.txt räcker för att göra din sida synlig för AI. Synligheten avgörs först av om boten kommer in på sidan och om den kan läsa innehållet.
JavaScript och rendering: den viktigaste tekniska poängen
Googlebot kan köra och rendera JavaScript, men de flesta AI-botar kör inte JavaScript alls. De läser bara den HTML som servern returnerar. Om viktigt innehåll förs in först i webbläsaren med JavaScript ser AI-boten i praktiken en tom sida.
Detta är artikelns viktigaste tekniska iakttagelse. Enligt en omfattande utredning från Vercel och MERJ (december 2024) körde GPTBot, OAI-SearchBot, ClaudeBot och PerplexityBot inte JavaScript. De kan ladda ner JavaScript-filerna (som en del av den hämtade datan), men kör dem inte, så innehåll som läggs till senare med kod förblir dolt för dem. Googlebot och vissa webbläsarbaserade agenter är undantag som renderar sidan.
I praktiken uppstår problemet när en sida byggs med ett tungt klientsidesramverk eller när priser, produktuppgifter, texter eller Schema-data injiceras på sidan först via Google Tag Manager eller ett annat skript. För en människa och för Google ser sidan komplett ut, men för AI-boten är det skelett som servern returnerar nästan tomt. Lösningen är att innehållet finns färdigt i den HTML som servern genererar, antingen serverrenderat (SSR) eller som en statisk sida.
Sidans skelett är en nästan tom <div id="root"></div>, och rubriker, texter och priser dyker upp först när webbläsaren kör JavaScript. AI-boten läser bara det tomma skelettet.
H1-rubriken, brödtexterna, priserna och application/ld+json finns direkt i den HTML som servern returnerar. Boten ser samma innehåll som en människa, utan JavaScript.
Hur testar du om AI ser din sida?
Du behöver inga specialverktyg. Med tre kontroller ser du snabbt om AI ser innehållet på din sida.
Tre sätt att testa synligheten för AI
- Kontrollera källkoden. Öppna Visa sidans källkod (View Source) i webbläsaren, inte DOM-vyn i DevTools. Leta efter om H1-rubriken, brödtexterna, priserna och
application/ld+jsonfinns direkt i HTML:en. Om de saknas i källkoden saknas de också för AI-boten. - Fråga modellerna direkt. Be ChatGPT, Claude och Perplexity att i realtid hämta information direkt från din sidas adress. Se om de får innehållet eller inte. Om någon modell inte hittar något har den en blockering eller ett renderingsproblem.
- Titta i server- och CDN-loggarna. Kontrollera i serverns loggar och i CDN:ets kontrollpanel (till exempel Cloudflares AI-vy) om AI-botarna får 200 OK som svar eller blockeringar som 403 eller 429. En blockeringskod visar att boten avvisas redan på nätverksnivå.
Behövs llms.txt och nya mirakelfiler?
Nya separata filer, som llms.txt, behövs inte nödvändigtvis. De stora AI-aktörerna har inte förbundit sig till dem, och en enskild fil åtgärdar inte att boten inte kommer in på sidan eller inte ser innehållet. Ungefär 80 procent av vanlig SEO gäller fortfarande.
Med andra ord bär grunderna fortfarande: teknisk tillgänglighet, tydlig sidstruktur, vettig intern länkning och trovärdighet (E-E-A-T, det vill säga erfarenhet, expertis, auktoritet och tillförlitlighet). Den största förändringen i AI-eran är att sidans kritiska innehåll och Schema-data måste gå att läsa direkt ur HTML:en utan JavaScript som körs av webbläsaren, och att botarna måste släppas in på sidan. När detta är i sin ordning är separata mirakelfiler på sin höjd finjustering.
| Faktor | Googlebot | De flesta AI-botar |
|---|---|---|
| Kör JavaScript | Ja, renderar sidan | Nej, läser bara serverns HTML |
| Tar sig oftast igenom brandväggen | Oftast ja | Ofta blockerad på IP- eller CDN-nivå |
| Följer robots.txt | Ja | Varierar, en användarbegäran förbigår ofta |
| Ser innehåll som bara laddats med JS | Ja (efter rendering) | Ser det inte |
Så löser Novavalo detta
Problemen som beskrivits ovan uppstår till stor del av hur en webbplats är tekniskt byggd. Novavalos tillvägagångssätt tar bort dem från grunden, eftersom sidorna produceras färdiga på servern.
Sidor som syns både för Google och för AI
Novavalo producerar statisk HTML som byggs färdig på servern och som AI-botarna kan läsa:
- Innehållet finns färdigt i HTML:en. Rubriker, texter, priser och Schema-data finns med redan i serverns svar, inte först bakom JavaScript.
- Inga onödiga botblockeringar. Sidorna levereras via ett snabbt CDN så att AI-botarna kommer in lika väl som Google.
- Strukturerad data automatiskt. För varje sida produceras en korrekt Schema-markering som AI kan läsa och citera.
- Test av GEO/AEO-synligheten. Du kan på ett begripligt språk kontrollera hur AI-sökningen ser ditt företag och få åtgärdsförslag.
Vanliga frågor
Varför syns min webbplats i Google men inte i AI-sökning?
Googlebot renderar JavaScript och ofta släpper även brandväggar igenom den, så Google ser sidan. De flesta AI-botar kör inte JavaScript, utan läser bara den råa HTML som servern returnerar, och de kan blockeras i brandväggen eller i CDN:et redan innan sidan läses. Om innehållet skapas först i webbläsaren eller boten är blockerad ser AI en tom sida.
Kör AI-botar JavaScript?
I huvudsak inte. Enligt en omfattande utredning kör GPTBot, OAI-SearchBot, ClaudeBot och PerplexityBot inte JavaScript, utan läser bara den HTML som servern returnerar. De kan ladda ner JS-filer men kör dem inte. Googlebot är ett undantag eftersom den renderar JavaScript.
Varför visar SEO-verktyget grönt trots att AI inte ser sidan?
Vanliga SEO-verktyg kontrollerar ofta bara robots.txt-filen och indexerbarheten. De märker inte om en brandvägg eller ett CDN blockerar AI-boten på IP-nivå, och inte heller att kritiskt innehåll laddas först med JavaScript. Därför kan verktyget visa att allt är i sin ordning trots att sidan förblir tom eller blockerad för AI-boten.
Hur testar jag om AI ser min sida?
Öppna sidans källkod (Visa sidans källkod) och kontrollera om H1-rubriken, brödtexterna, priserna och application/ld+json-schemat finns direkt i HTML:en. Be sedan ChatGPT, Claude eller Perplexity att hämta information direkt från din sidas adress och se om det lyckas. Kontrollera till sist i serverns eller CDN:ets loggar om AI-botarna får 200 OK som svar eller blockeringar som 403 eller 429.
Behöver jag en llms.txt-fil?
Inte nödvändigtvis. De stora AI-aktörerna har inte förbundit sig till llms.txt-filen, och den ersätter inte grunderna. Ungefär 80 procent av vanlig SEO gäller fortfarande: tillgänglighet, tydlig struktur, intern länkning och trovärdighet (E-E-A-T). Den viktigaste förändringen är att kritiskt innehåll och Schema-data måste gå att läsa direkt ur HTML:en utan JavaScript.
Är Novavalos sidor synliga för AI?
Ja. Novavalo producerar statisk HTML som byggs färdig på servern, där rubriker, texter, priser och Schema-data finns med utan beroende av JavaScript. Sidorna levereras via ett snabbt CDN utan IP-blockeringar av AI-botar, så AI-boten ser samma innehåll som en människa.
Syns även i AI-sökning
Låt AI:n bygga en webbplats åt ditt företag, där innehållet finns färdigt i serverns HTML och som både Google och AI-sökning ser. Du ser slutresultatet på några minuter.
Börja gratis →Transparensnotis: Den här artikeln har producerats med hjälp av AI och Novavalos redaktion ansvarar för innehållet. Artikeln är allmän information om AI-sökning och teknisk SEO. Botarna och deras praxis förändras snabbt, så kontrollera aktuell information i de officiella källorna nedan.