AI-søk · Teknisk SEO
Derfor lykkes nettstedet ditt på Google, men er usynlig for AI
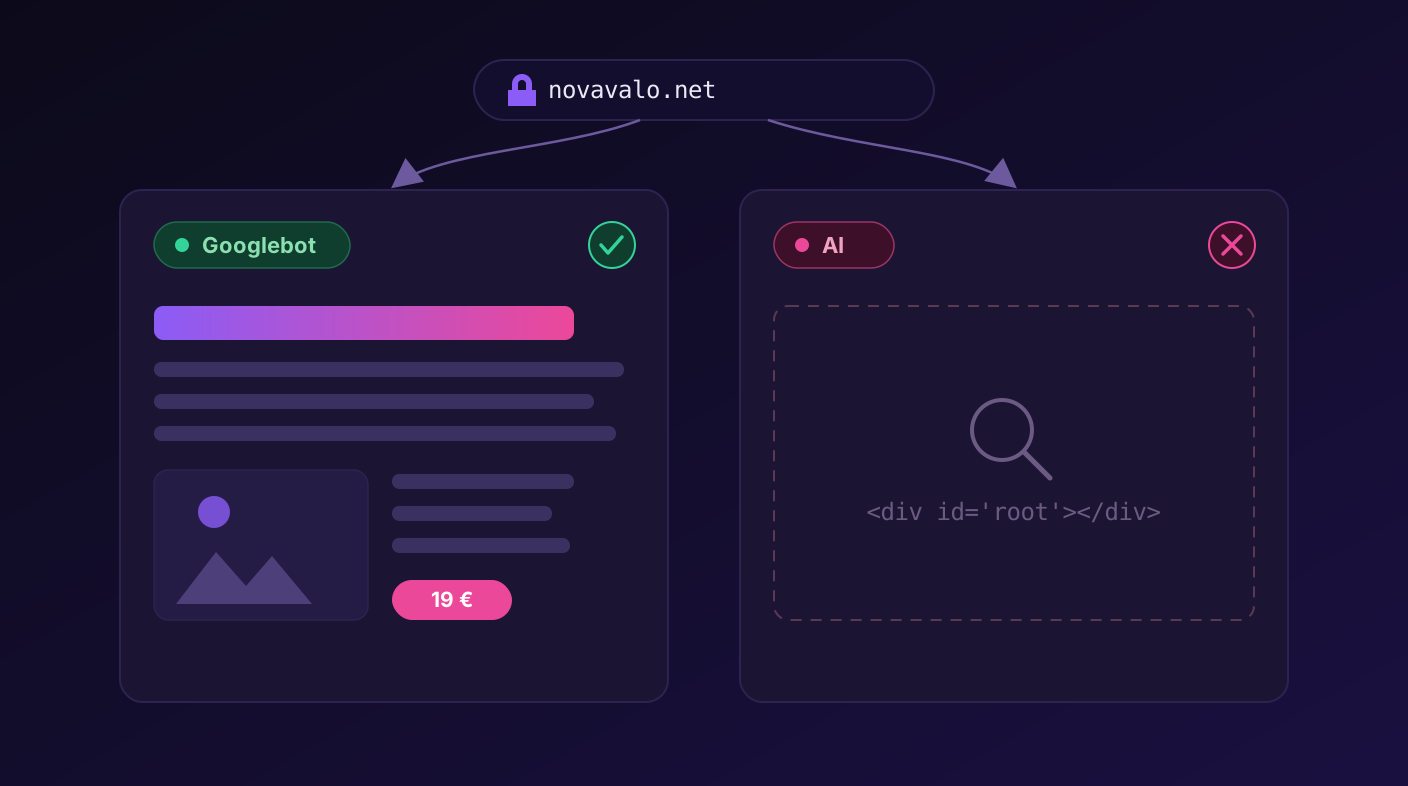
Nettstedet ditt kan rangere godt på Google, få grønne merker i SEO-verktøy og likevel være nesten usynlig for AI-søk og AI-agenter. ChatGPT, Claude, Perplexity og Gemini ser ikke nettet på samme måte som Google. I denne artikkelen går vi gjennom tre grunner til at AI-en ikke ser siden din, hvordan du tester saken selv, og hvorfor HTML generert på serveren løser problemet.
Kort fortalt: hvis det viktige innholdet ditt (overskrifter, tekster, priser, Schema-data) først lastes i nettleseren med JavaScript, ser mange AI-boter en tom side. Det samme gjelder situasjonen der en brannmur eller et CDN blokkerer AI-boten. SEO-verktøyet ditt forteller deg kanskje ingenting om dette.
Google og AI-søk leser nettet på ulike måter. Googlebot renderer JavaScript og slipper som regel gjennom brannmurer. De fleste AI-boter kjører ikke JavaScript, men leser bare den rå HTML-en som serveren returnerer, og de kan blokkeres allerede i brannmuren eller CDN-et.
Derfor kan et nettsted lykkes på Google, men forbli usynlig for AI. Vanlige SEO-verktøy oppdager ikke dette, fordi de hovedsakelig leser robots.txt-filen og ikke det faktiske innholdet som serveres til botene.
Løsningen er at det kritiske innholdet og Schema-dataen ligger ferdig i HTML-en som serveren returnerer (SSR eller statisk side), og at AI-botene ikke er blokkert. Novavalo lager nettopp slik statisk HTML, så sider bygget med Novavalo vises både for Google og for AI.
Ulike boter til ulike formål
AI-selskapene har ikke én bot, men flere separate boter til ulike oppgaver: én samler materiale til å trene modellen, en annen bygger en søkeindeks, og en tredje henter siden akkurat når en bruker ber om det. Nettstedet ditt kan tillate den ene og blokkere den andre uten å merke det.
For eksempel kjører både OpenAI og Anthropic flere boter. Hos OpenAI samler GPTBot treningsdata, OAI-SearchBot bygger søkeresultater og ChatGPT-User henter siden på brukerens sanntidsforespørsel. Hos Anthropic samler tilsvarende ClaudeBot materiale, Claude-SearchBot sjekker sider for søk, og Claude-User henter siden når noen spør Claude om noe fra den aktuelle adressen.
Google er et unntak her. Selskapet har ikke en egen AI-bot på samme måte, men den tradisjonelle Googlebot står i hovedsak også for bakgrunnsarbeidet til AI Overview-resultatene og AI-funksjonene. Derfor fungerer ikke det som fungerer for Google automatisk for andre AI-aktører: Google er allerede på innsiden, mens separate AI-boter må slippes inn særskilt og må kunne lese siden.
Brannmurer og CDN blokkerer boter før robots.txt
Et sikkerhetslag, som Cloudflare, en WAF-brannmur eller webhotellets blokkeringsinnstillinger, kan avvise AI-boten allerede på IP-nivå, før boten i det hele tatt rekker å lese robots.txt-filen. Da får ikke boten siden i det hele tatt, uansett hvor godt innholdet ditt er.
Mange CDN- og sikkerhetstjenester har begynt å blokkere kjente AI-boter som standard eller med ett klikk. Det kan være et bevisst valg, men ofte har det blitt stående på ved et uhell eller blitt satt opp av noen andre. Resultatet er at en menneskelig besøkende og Googlebot kommer inn på siden, mens for eksempel ClaudeBot får en blokkering som svar.
I et reelt eksempeltilfelle kom ChatGPT inn på nettstedet, men Anthropics Claude var blokkert i serverens brannmur. For brukeren viser dette seg ved at den ene AI-assistenten kan fortelle om bedriften og den andre ikke finner noe om den. Et vanlig SEO-verktøy avslører ikke problemet, fordi det bare leser robots.txt-filen, der blokkeringen ikke vises: blokkeringen skjer på nettverksnivå langt tidligere.
Robots.txt holder ikke alltid
Et annet overraskende forhold er at robots.txt ikke er bindende for alle boter. Boter som beveger seg på brukerens forespørsel, overser forbudene ofte. OpenAI har selv uttalt at siden en ChatGPT-User-forespørsel startes av et menneske, gjelder robots.txt-reglene ikke nødvendigvis for den.
Dette er ikke bare teori. Ifølge bransjeundersøkelser nådde ChatGPT-User sider på omtrent halvparten av de europeiske nettstedene som uttrykkelig hadde blokkert den i robots.txt-filen. Den praktiske lærdommen går begge veier: du kan ikke stole på at robots.txt blokkerer sanntidsagenter, og du kan heller ikke anta at det å tillate i robots.txt alene er nok til å gjøre siden din synlig for AI. Synligheten avgjøres først av om boten kommer inn på siden og klarer å lese innholdet.
JavaScript og rendering: det viktigste tekniske poenget
Googlebot kan kjøre og rendere JavaScript, men de fleste AI-boter kjører ikke JavaScript i det hele tatt. De leser bare den HTML-en som serveren returnerer. Hvis viktig innhold først hentes inn i nettleseren med JavaScript, ser AI-boten i praksis en tom side.
Dette er artikkelens viktigste tekniske funn. Ifølge en omfattende undersøkelse fra Vercel og MERJ (desember 2024) kjørte ikke GPTBot, OAI-SearchBot, ClaudeBot og PerplexityBot JavaScript. De kan laste ned JavaScript-filene (som en del av dataen de henter), men kjører dem ikke, så innhold som legges til senere med kode, forblir skjult for dem. Googlebot og enkelte nettleserbaserte agenter er unntak som renderer siden.
I praksis oppstår problemet når siden bygges med et tungt client-side-rammeverk, eller når priser, produktinformasjon, tekster eller Schema-data injiseres på siden først via Google Tag Manager eller et annet skript. For et menneske og for Google ser siden fullstendig ut, men for AI-boten er skjelettet som serveren returnerer nesten tomt. Løsningen er at innholdet ligger ferdig i HTML-en som serveren genererer, enten serverrendert (SSR) eller som en statisk side.
Sidens skjelett er et nesten tomt <div id="root"></div>, og overskrifter, tekster og priser dukker først opp når nettleseren kjører JavaScript. AI-boten leser bare det tomme skjelettet.
H1-overskriften, brødtekstene, prisene og application/ld+json ligger direkte i HTML-en som serveren returnerer. Boten ser det samme innholdet som et menneske, uten JavaScript.
Hvordan tester du om AI-en ser siden din?
Du trenger ikke spesialverktøy. Med tre sjekker ser du raskt om AI-en ser innholdet på siden din.
Tre måter å teste synligheten for AI på
- Sjekk kildekoden. Åpne Vis sidekilde (View Source) i nettleseren, ikke DOM-visningen i DevTools. Let etter om H1-overskriften, brødtekstene, prisene og
application/ld+jsonfinnes direkte i HTML-en. Hvis de mangler i kildekoden, mangler de også for AI-boten. - Spør modellene direkte. Be ChatGPT, Claude og Perplexity om å hente informasjon i sanntid direkte fra nettadressen din. Se om de får innholdet eller ikke. Hvis en modell ikke finner noe, har den en blokkering eller et renderingsproblem.
- Se på server- og CDN-loggene. Sjekk i serverloggene og i CDN-ets kontrollpanel (for eksempel Cloudflares AI-visning) om AI-botene får 200 OK som svar eller blokkeringer som 403 eller 429. En blokkeringskode forteller at boten avvises allerede på nettverksnivå.
Trengs llms.txt og nye mystiske filer?
Nye separate filer, som llms.txt, trengs ikke nødvendigvis. De store AI-aktørene har ikke forpliktet seg til dem, og en enkelt fil retter ikke at boten ikke kommer inn på siden eller ikke ser innholdet. Rundt 80 prosent av vanlig SEO gjelder fortsatt.
Med andre ord bærer det grunnleggende fortsatt: teknisk tilgjengelighet, tydelig sidestruktur, fornuftig intern lenking og troverdighet (E-E-A-T, altså erfaring, ekspertise, autoritet og troverdighet). Den største endringen i AI-tiden er at sidens kritiske innhold og Schema-data må kunne leses direkte fra HTML-en uten JavaScript kjørt av nettleseren, og at botene må slippes inn på siden. Når dette er på plass, er separate mystiske filer på sin høyde finjustering.
| Faktor | Googlebot | De fleste AI-boter |
|---|---|---|
| Kjører JavaScript | Ja, renderer siden | Nei, leser bare serverens HTML |
| Slipper som regel gjennom brannmuren | Vanligvis ja | Ofte blokkert på IP- eller CDN-nivå |
| Følger robots.txt | Ja | Varierer, brukerens forespørsel overstyrer ofte |
| Ser bare innhold lastet med JS | Ja (etter rendering) | Ser det ikke |
Slik løser Novavalo dette
Problemene beskrevet ovenfor oppstår i stor grad av hvordan nettstedet er teknisk bygget. Novavalos tilnærming fjerner dem i utgangspunktet, fordi sidene produseres ferdig på serveren.
Sider som vises både for Google og for AI
Novavalo lager statisk HTML som er ferdigbygd på serveren, og som AI-botene klarer å lese:
- Innholdet ligger ferdig i HTML-en. Overskrifter, tekster, priser og Schema-data er med allerede i serverens svar, ikke først bak JavaScript.
- Ingen unødvendige botblokkeringer. Sidene leveres via et raskt CDN slik at AI-botene kommer inn, like fullt som Google.
- Strukturert data automatisk. For hver side produseres en passende Schema-merking som AI kan lese og sitere.
- Test av GEO/AEO-synlighet. Du kan sjekke på klarspråk hvordan AI-søk ser bedriften din, og få forslag til forbedringer.
Ofte stilte spørsmål
Hvorfor vises nettstedet mitt på Google, men ikke i AI-søk?
Googlebot renderer JavaScript, og ofte slipper brannmurene den også gjennom, så Google ser siden. De fleste AI-boter kjører ikke JavaScript, men leser bare den rå HTML-en som serveren returnerer, og de kan blokkeres i brannmuren eller CDN-et allerede før siden leses. Hvis innholdet først oppstår i nettleseren, eller boten er blokkert, ser AI-en en tom side.
Kjører AI-boter JavaScript?
Stort sett ikke. Ifølge en omfattende undersøkelse kjører ikke GPTBot, OAI-SearchBot, ClaudeBot og PerplexityBot JavaScript, men leser bare HTML-en som serveren returnerer. De kan laste ned JS-filene, men kjører dem ikke. Googlebot er et unntak, fordi den renderer JavaScript.
Hvorfor viser SEO-verktøyet grønt selv om AI-en ikke ser siden?
Vanlige SEO-verktøy sjekker ofte bare robots.txt-filen og indekserbarheten. De oppdager ikke om en brannmur eller et CDN blokkerer AI-boten på IP-nivå, og heller ikke at kritisk innhold først lastes med JavaScript. Derfor kan verktøyet vise at alt er i orden, selv om siden forblir tom eller blokkert for AI-boten.
Hvordan tester jeg om AI-en ser siden min?
Åpne sidens kildekode (Vis sidekilde) og sjekk om H1-overskriften, brødtekstene, prisene og application/ld+json-schemaet finnes direkte i HTML-en. Be deretter ChatGPT, Claude eller Perplexity om å hente informasjon direkte fra nettadressen din, og se om det lykkes. Sjekk til slutt i server- eller CDN-loggene om AI-botene får 200 OK som svar eller blokkeringer som 403 eller 429.
Trenger jeg en llms.txt-fil?
Ikke nødvendigvis. De store AI-aktørene har ikke forpliktet seg til llms.txt-filen, og den erstatter ikke det grunnleggende. Rundt 80 prosent av vanlig SEO gjelder fortsatt: tilgjengelighet, tydelig struktur, intern lenking og troverdighet (E-E-A-T). Den viktigste endringen er at kritisk innhold og Schema-data må kunne leses direkte fra HTML-en uten JavaScript.
Er Novavalos sider synlige for AI?
Ja. Novavalo lager statisk HTML som er ferdigbygd på serveren, der overskrifter, tekster, priser og Schema-data er med uten JavaScript-avhengighet. Sidene leveres via et raskt CDN uten IP-blokkeringer av AI-boter, så AI-boten ser det samme innholdet som et menneske.
Bli synlig også i AI-søk
La AI bygge et nettsted for bedriften din der innholdet ligger ferdig i serverens HTML, og som både Google og AI-søk ser. Du ser resultatet på noen få minutter.
Kom i gang gratis →Åpenhetsmerknad: Denne artikkelen er produsert med hjelp av kunstig intelligens, og Novavalos redaksjon er ansvarlig for innholdet. Artikkelen er generell informasjon om AI-søk og teknisk SEO. Boter og deres praksis endrer seg raskt, så sjekk de oppdaterte opplysningene i de offisielle kildene nedenfor.