Tehisintellekti otsing · Tehniline SEO
Miks sinu veebisait menestub Googles, kuid on tehisintellektile nähtamatu
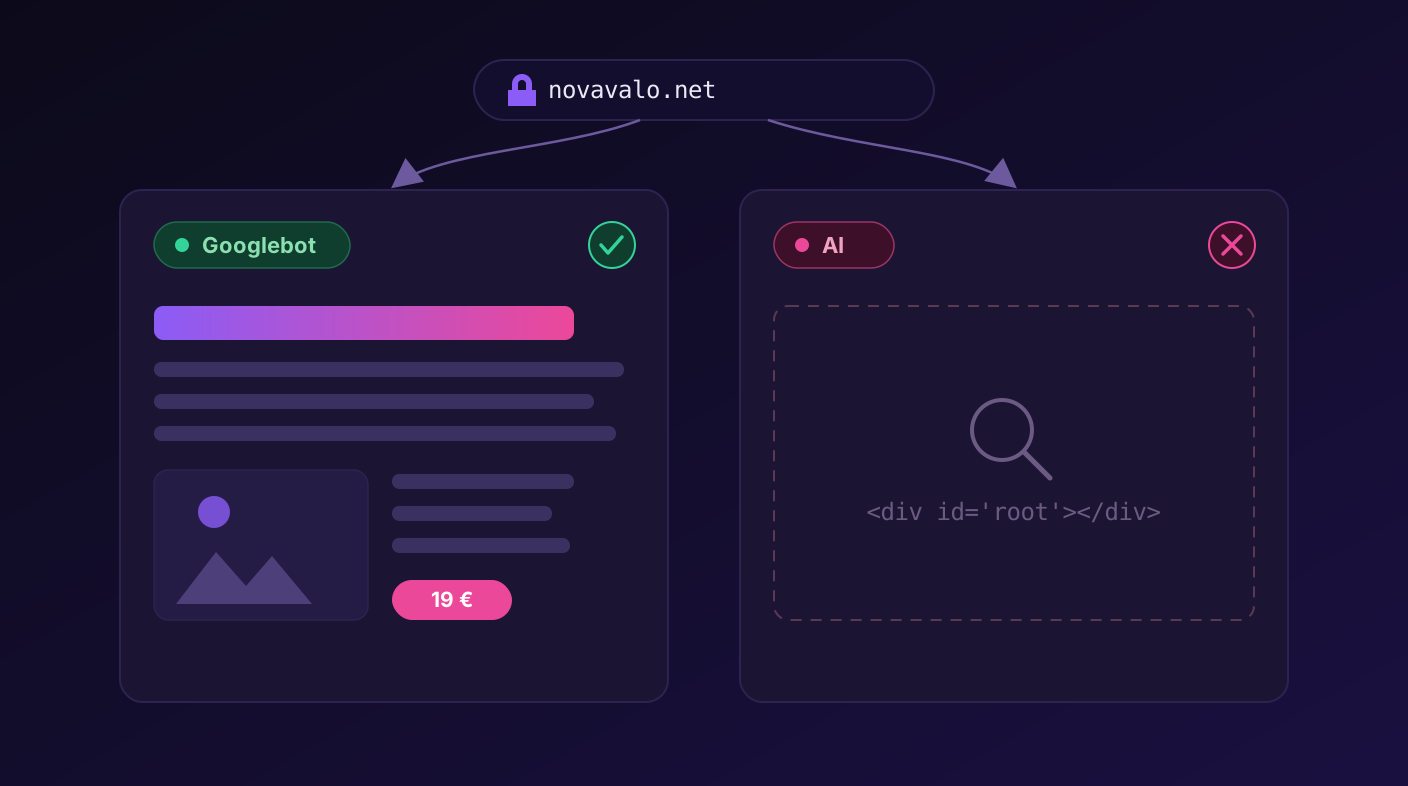
Sinu veebisait võib Googles hästi reastuda, saada SEO-tööriistades rohelised märgid ja ometi olla tehisintellekti otsingule ja AI-agentidele peaaegu nähtamatu. ChatGPT, Claude, Perplexity ja Gemini ei näe veebi samamoodi nagu Google. Selles artiklis käime läbi kolm põhjust, miks tehisintellekt sinu lehte ei näe, kuidas sa seda ise testid ja miks serveri genereeritud HTML probleemi lahendab.
Lühidalt: kui sinu oluline sisu (pealkirjad, tekstid, hinnad, Schema-andmed) laaditakse alles brauseris JavaScriptiga, näeb paljud tehisintellekti botid tühja lehte. Sama kehtib olukorras, kus tulemüür või CDN blokeerib AI-boti. Sinu SEO-tööriist ei pruugi sellest midagi öelda.
Google ja tehisintellekti otsing loevad veebi erinevalt. Googlebot renderdab JavaScripti ja pääseb enamasti tulemüüridest läbi. Enamik tehisintellekti botte ei käivita JavaScripti, vaid loevad ainult serveri tagastatud toorest HTML-i, ning neid saab blokeerida juba tulemüüris või CDN-is.
Seetõttu võib veebisait menestuda Googles, kuid jääda tehisintellektile nähtamatuks. Tavalised SEO-tööriistad seda ei märka, sest nad loevad peamiselt robots.txt-faili, mitte varsti botidele serveeritavat sisu.
Lahendus on, et kriitiline sisu ja Schema-andmed on valmis serveri tagastatud HTML-is (SSR või staatiline leht) ja AI-botid ei ole blokeeritud. Novavalo toodab just sellist staatilist HTML-i, mistõttu Novavaloga ehitatud lehed on nähtavad nii Google'ile kui ka tehisintellektile.
Erinevad botid erinevateks ülesanneteks
Tehisintellekti ettevõtetel ei ole üht botti, vaid mitu eraldi botti erinevateks ülesanneteks: üks kogub materjali mudeli treenimiseks, teine ehitab otsinguindeksit ja kolmas hangib lehe siis, kui kasutaja seda just parasjagu küsib. Sinu veebisait võib ühe lubada ja teise märkamatult blokeerida.
Näiteks OpenAI ja Anthropic kasutavad mõlemad mitut botti. OpenAI-l kogub GPTBot treeningandmeid, OAI-SearchBot ehitab otsingutulemusi ja ChatGPT-User hangib lehe kasutaja reaalajas tehtud päringu alusel. Anthropicil kogub vastavalt ClaudeBot materjali, Claude-SearchBot kontrollib lehti otsingu jaoks ja Claude-User toob lehe, kui keegi küsib Claude'ilt midagi konkreetse aadressi kohta.
Google on siin erand. Tal ei ole eraldi AI-botti samamoodi, vaid traditsiooniline Googlebot teeb peamiselt ka AI Overview'i tulemuste ja tehisintellekti funktsioonide taustatöö. Seetõttu ei toimi see, mis töötab Google'ile, automaatselt teiste tehisintellekti tegijate jaoks: Google on juba valmis sees, samal ajal kui eraldi AI-botid tuleb eraldi sisse lasta ja nad peavad suutma lehe lugeda.
Tulemüürid ja CDN blokeerivad botte enne robots.txt-i
Kaitsekiht, näiteks Cloudflare, WAF-tulemüür või veebimajutuse blokeerimissätted, võib tõrjuda tehisintellekti boti juba IP-tasandil, enne kui bott jõuab üldse robots.txt-faili lugeda. Sel juhul ei saa bott lehte üldse, olgu sinu sisu kui tahes hea.
Paljud CDN- ja turvateenused on hakanud tuntud AI-botte vaikimisi või ühe klõpsuga blokeerima. See võib olla teadlik valik, kuid sageli on see kogemata peale jäänud või kellegi teise poolt seadistatud. Tulemus on, et inimkülastaja ja Googlebot pääsevad lehele, aga näiteks ClaudeBot saab vastuseks blokeeringu.
Ühes tegelikus näitejuhtumis pääses ChatGPT veebisaidile, kuid Anthropicu Claude oli serveri tulemüüris blokeeritud. Kasutajale paistab see nii, et üks tehisintellekti assistent oskab ettevõttest rääkida ja teine ei leia selle kohta midagi. Tavaline SEO-tööriist probleemi ei paljasta, sest see loeb ainult robots.txt-faili, kus blokeeringut ei näe: blokeering toimub võrgutasandil palju varem.
Robots.txt ei pea alati paika
Teine üllatav asjaolu on, et robots.txt ei ole kõigi botide jaoks siduv. Kasutaja päringu alusel liikuvad botid eiravad keelde sageli. OpenAI on ise nentinud, et kuna ChatGPT-User-päringu käivitab inimene, ei pruugi robots.txt-reeglid sellele kehtida.
See ei ole pelgalt teooria. Valdkonna uuringute kohaselt jõudis ChatGPT-User lehtedele umbes pooltel neist Euroopa veebisaitidest, mis olid selle robots.txt-failis sõnaselgelt blokeerinud. Praktiline õppetund on kahesuunaline: sa ei saa loota, et robots.txt reaalajas agente peataks, ega saa teisalt eeldada, et pelk robots.txt-luba teeks sinu lehe tehisintellektile nähtavaks. Nähtavus selgub alles selles, kas bott pääseb lehele ja kas ta suudab sisu lugeda.
JavaScript ja renderdamine: kõige olulisem tehniline punkt
Googlebot oskab JavaScripti käivitada ja renderdada, kuid enamik tehisintellekti botte ei käivita JavaScripti üldse. Nad loevad ainult seda HTML-i, mille server tagastab. Kui oluline sisu tuuakse alles brauseris JavaScriptiga, näeb tehisintellekti bott praktikas tühja lehte.
See on artikli kõige olulisem tehniline tähelepanek. Verceli ja MERJ-i ulatusliku uuringu (detsember 2024) kohaselt GPTBot, OAI-SearchBot, ClaudeBot ja PerplexityBot JavaScripti ei käivitanud. Nad võivad JavaScripti-failid alla laadida (osana hangitud andmetest), kuid ei käivita neid, seega jääb koodiga hiljem lisatav sisu neile peidetuks. Googlebot ja mõned brauseripõhised agendid on erandid, mis lehe renderdavad.
Praktikas tekib probleem siis, kui leht ehitatakse raske client-side-raamistikuga või kui hinnad, tooteandmed, tekstid või Schema-andmed süstitakse lehele alles Google Tag Manageri või muu skripti kaudu. Inimesele ja Google'ile paistab leht täielik, kuid tehisintellekti botile on serveri tagastatud skelett peaaegu tühi. Lahendus on, et sisu on valmis serveri genereeritud HTML-is, kas serveris renderdatuna (SSR) või staatilise lehena.
Lehe skelett on peaaegu tühi <div id="root"></div> ja pealkirjad, tekstid ning hinnad ilmuvad alles siis, kui brauser JavaScripti käivitab. Tehisintellekti bott loeb ainult tühja skeleti.
H1-pealkiri, põhitekstid, hinnad ja application/ld+json on otse serveri tagastatud HTML-is. Bott näeb sama sisu nagu inimene, ilma JavaScriptita.
Kuidas testid, kas tehisintellekt näeb sinu lehte?
Sa ei vaja eritööriistu. Kolme kontrolliga näed kiiresti, kas tehisintellekt näeb sinu lehe sisu.
Kolm viisi, kuidas testida nähtavust tehisintellektile
- Kontrolli lähtekoodi. Ava brauseris Kuva lehe lähtekood (View Source), mitte DevToolsi DOM-vaade. Otsi, kas H1-pealkiri, põhitekstid, hinnad ja
application/ld+jsonleiduvad otse HTML-is. Kui need puuduvad lähtekoodist, puuduvad need ka tehisintellekti botilt. - Küsi mudelitelt otse. Palu ChatGPT-l, Claude'il ja Perplexityl hankida reaalajas teavet otse sinu lehe aadressilt. Vaata, kas nad saavad sisu kätte või mitte. Kui mõni mudel ei leia midagi, on tal blokeering või renderdamisprobleem.
- Vaata serveri ja CDN-i logisid. Kontrolli serveri logidest ja CDN-i halduspaneelist (näiteks Cloudflare'i AI-vaade), kas AI-botid saavad vastuseks 200 OK või blokeeringuid nagu 403 või 429. Blokeerimiskood näitab, et bott tõrjutakse juba võrgutasandil.
Kas on vaja llms.txt-i ja uusi imefaile?
Uusi eraldi faile, nagu llms.txt, ei ole tingimata vaja. Suured tehisintellekti tegijad ei ole nendega sidunud ega paranda üksik fail seda, et bott lehele ei pääse või et ta sisu ei näe. Umbes 80 protsenti tavalisest SEO-st kehtib endiselt.
Teisisõnu, põhiasjad kannavad ikka: tehniline ligipääsetavus, selge lehestruktuur, mõistlik sisemine linkimine ja usaldusväärsus (E-E-A-T ehk kogemus, asjatundlikkus, autoriteet ja usaldusväärsus). Kõige suurem muutus tehisintellekti ajastul on, et lehe kriitiline sisu ja Schema-andmed peavad olema loetavad otse HTML-ist ilma brauseri käivitatud JavaScriptita, ja et botid tuleb lehele lubada. Kui see on korras, on eraldi imefailid kõige rohkem peenhäälestus.
| Tegur | Googlebot | Enamik AI-botte |
|---|---|---|
| Käivitab JavaScripti | Jah, renderdab lehe | Ei, loeb ainult serveri HTML-i |
| Pääseb enamasti tulemüürist läbi | Üldiselt jah | Sageli blokeeritud IP- või CDN-tasandil |
| Järgib robots.txt-i | Jah | Varieerub, kasutaja päring eirab sageli |
| Näeb ainult JS-iga laaditud sisu | Jah (pärast renderdamist) | Ei näe |
Kuidas Novavalo selle lahendab
Eelkirjeldatud probleemid tekivad suuresti sellest, kuidas veebisait on tehniliselt ehitatud. Novavalo lähenemine kõrvaldab need juba lähtekohas, sest lehed toodetakse serveris valmis.
Lehed, mis on nähtavad nii Google'ile kui ka tehisintellektile
Novavalo toodab serveris valmis ehitatud staatilise HTML-i, mida tehisintellekti botid oskavad lugeda:
- Sisu on valmis HTML-is. Pealkirjad, tekstid, hinnad ja Schema-andmed on kaasas juba serveri vastuses, mitte alles JavaScripti taga.
- Ei liigseid botiblokeeringuid. Lehti serveeritakse kiire CDN-i kaudu nii, et tehisintellekti botid pääsevad sisse sama hästi kui Google.
- Struktureeritud andmed automaatselt. Igale lehele toodetakse asjakohane Schema-märgistus, mida tehisintellekt oskab lugeda ja tsiteerida.
- GEO/AEO-nähtavuse test. Saad selges keeles kontrollida, kuidas tehisintellekti otsing sinu ettevõtet näeb, ja saada parandusettepanekud.
Korduma kippuvad küsimused
Miks minu veebisait on Googles nähtav, kuid tehisintellekti otsingus mitte?
Googlebot renderdab JavaScripti ja sageli lasevad ka tulemüürid ta läbi, seega Google näeb lehte. Enamik tehisintellekti botte ei käivita JavaScripti, vaid loevad ainult serveri tagastatud toorest HTML-i, ning neid saab tulemüüris või CDN-is blokeerida juba enne lehe lugemist. Kui sisu tekib alles brauseris või bott on blokeeritud, näeb tehisintellekt tühja lehte.
Kas tehisintellekti botid käivitavad JavaScripti?
Enamasti mitte. Ulatusliku uuringu kohaselt GPTBot, OAI-SearchBot, ClaudeBot ja PerplexityBot ei käivita JavaScripti, vaid loevad ainult serveri tagastatud HTML-i. Nad võivad JS-failid alla laadida, kuid ei käivita neid. Googlebot on erand, sest ta renderdab JavaScripti.
Miks SEO-tööriist näitab rohelist, kuigi tehisintellekt lehte ei näe?
Tavalised SEO-tööriistad kontrollivad sageli ainult robots.txt-faili ja indekseeritavust. Nad ei märka, kui tulemüür või CDN blokeerib tehisintellekti boti IP-tasandil, ega seda, et kriitiline sisu laaditakse alles JavaScriptiga. Seetõttu võib tööriist näidata, et kõik on korras, kuigi tehisintellekti botile jääb leht tühjaks või blokeerituks.
Kuidas ma testin, kas tehisintellekt näeb minu lehte?
Ava lehe lähtekood (Kuva lehe lähtekood) ja kontrolli, kas H1-pealkiri, põhitekstid, hinnad ja application/ld+json-schema leiduvad otse HTML-is. Palu seejärel ChatGPT-l, Claude'il või Perplexityl hankida teavet otse sinu lehe aadressilt ja vaata, kas see õnnestub. Kontrolli lõpuks serveri või CDN-i logidest, kas AI-botid saavad vastuseks 200 OK või blokeeringuid nagu 403 või 429.
Kas mul on vaja llms.txt-faili?
Mitte tingimata. Suured tehisintellekti tegijad ei ole llms.txt-failiga sidunud ega asenda see põhiasju. Umbes 80 protsenti tavalisest SEO-st kehtib endiselt: ligipääsetavus, selge struktuur, sisemine linkimine ja usaldusväärsus (E-E-A-T). Kõige olulisem muutus on, et kriitiline sisu ja Schema-andmed peavad olema loetavad otse HTML-ist ilma JavaScriptita.
Kas Novavalo lehed on tehisintellektile nähtavad?
Jah. Novavalo toodab serveris valmis ehitatud staatilise HTML-i, milles pealkirjad, tekstid, hinnad ja Schema-andmed on kaasas ilma JavaScripti sõltuvuseta. Lehti serveeritakse kiire CDN-i kaudu ilma tehisintellekti bottide IP-blokeeringuta, nii et tehisintellekti bott näeb sama sisu nagu inimene.
Ole nähtav ka tehisintellekti otsingus
Lase tehisintellektil ehitada oma ettevõttele veebisait, mille sisu on valmis serveri HTML-is ja mida näevad nii Google kui ka tehisintellekti otsing. Näed tulemust mõne minutiga.
Alusta tasuta →Läbipaistvuse märkus: See artikkel on loodud tehisintellekti abiga ja Novavalo toimetus vastutab selle sisu eest. Artikkel on üldine teave tehisintellekti otsingu ja tehnilise SEO kohta. Botid ja nende tavad muutuvad kiiresti, seega kontrolli ajakohast teavet allolevatest ametlikest allikatest.