KI-Suche · Technisches SEO
Warum deine Website bei Google erfolgreich ist, für die KI aber unsichtbar
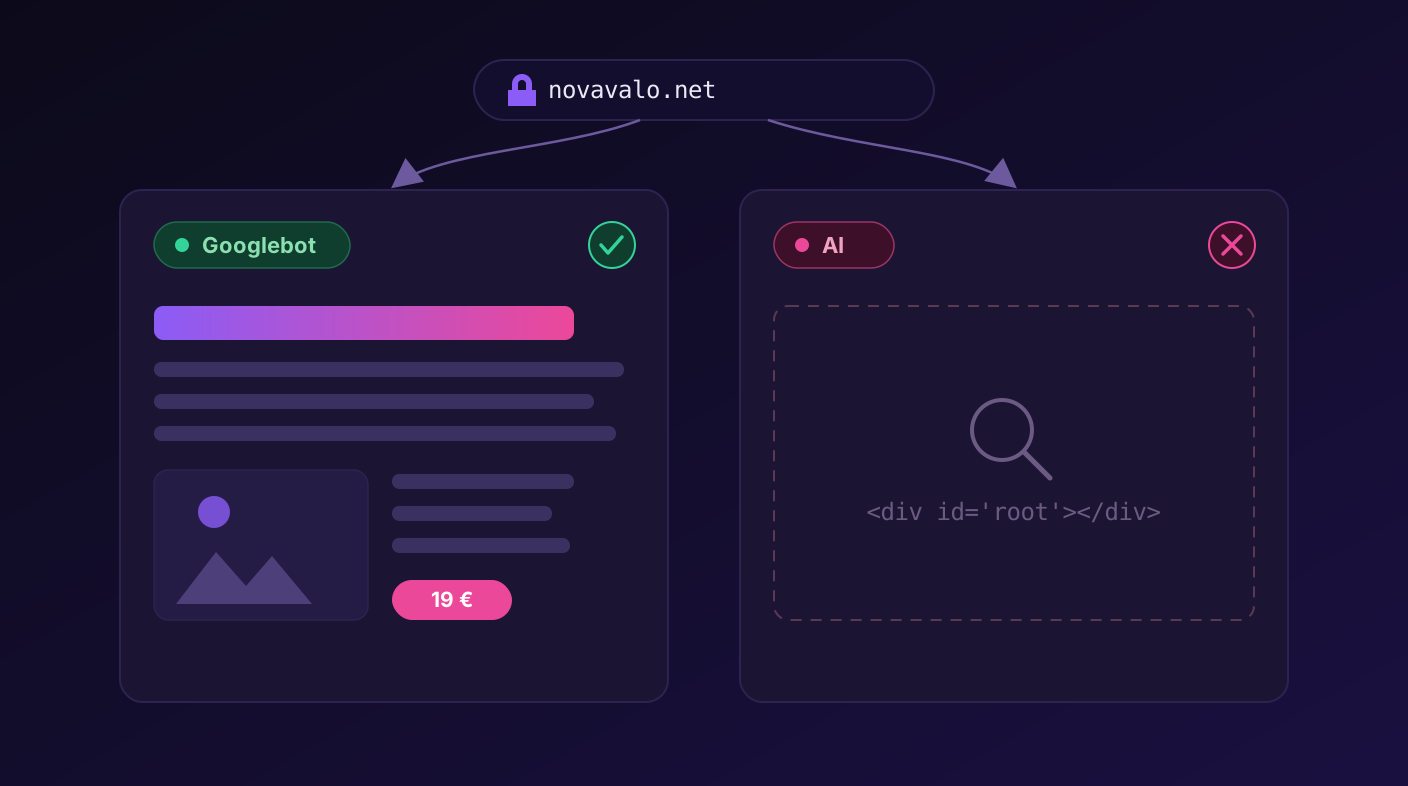
Deine Website kann bei Google gut ranken, grüne Markierungen in SEO-Tools bekommen und für die KI-Suche und KI-Agenten trotzdem fast unsichtbar sein. ChatGPT, Claude, Perplexity und Gemini sehen das Web nicht auf dieselbe Weise wie Google. In diesem Artikel gehen wir drei Gründe durch, warum die KI deine Seite nicht sieht, wie du die Sache selbst testest und warum das vom Server erzeugte HTML das Problem löst.
Kurz gesagt: Wenn dein wichtiger Inhalt (Überschriften, Texte, Preise, Schema-Daten) erst im Browser per JavaScript geladen wird, sieht mancher KI-Bot eine leere Seite. Dasselbe gilt, wenn eine Firewall oder ein CDN den KI-Bot blockiert. Dein SEO-Tool verrät dir davon womöglich nichts.
Google und die KI-Suche lesen das Web unterschiedlich. Googlebot rendert JavaScript und kommt meist durch Firewalls hindurch. Die meisten KI-Bots führen kein JavaScript aus, sondern lesen nur das rohe HTML, das der Server zurückgibt, und sie können schon in der Firewall oder im CDN blockiert werden.
Deshalb kann eine Website bei Google erfolgreich sein, für die KI aber unsichtbar bleiben. Gewöhnliche SEO-Tools bemerken das nicht, weil sie vor allem die robots.txt-Datei lesen und nicht den Inhalt, der den Bots tatsächlich ausgeliefert wird.
Die Lösung ist, dass der kritische Inhalt und die Schema-Daten fertig im HTML stehen, das der Server zurückgibt (SSR oder statische Seite), und dass die KI-Bots nicht blockiert sind. Novavalo erzeugt genau solches statisches HTML, deshalb sind mit Novavalo gebaute Seiten sowohl für Google als auch für die KI sichtbar.
Verschiedene Bots für verschiedene Zwecke
KI-Unternehmen haben nicht einen einzigen Bot, sondern mehrere eigenständige Bots für verschiedene Aufgaben: Der eine sammelt Material für das Training des Modells, der zweite baut einen Suchindex auf und der dritte holt die Seite genau dann, wenn ein Nutzer sie gerade anfordert. Deine Website kann den einen zulassen und den anderen unbemerkt blockieren.
OpenAI und Anthropic betreiben zum Beispiel jeweils mehrere Bots. Bei OpenAI sammelt GPTBot Trainingsdaten, OAI-SearchBot baut Suchergebnisse auf und ChatGPT-User holt die Seite auf die Echtzeit-Anfrage eines Nutzers hin. Bei Anthropic sammelt entsprechend ClaudeBot Material, Claude-SearchBot prüft Seiten für die Suche und Claude-User ruft die Seite ab, wenn jemand Claude etwas zu der betreffenden Adresse fragt.
Google ist hier eine Ausnahme. Es hat keinen eigenen KI-Bot auf dieselbe Weise, sondern der klassische Googlebot übernimmt überwiegend auch die Hintergrundarbeit für AI-Overview-Ergebnisse und KI-Funktionen. Deshalb funktioniert das, was für Google klappt, nicht automatisch auch für andere KI-Anbieter: Google ist bereits drinnen, während die eigenständigen KI-Bots gesondert hereingelassen werden müssen und die Seite auch lesen können müssen.
Firewalls und CDNs blockieren Bots schon vor der robots.txt
Eine Schutzschicht wie Cloudflare, eine WAF-Firewall oder die Sperreinstellungen eines Webhosters kann den KI-Bot schon auf IP-Ebene abweisen, bevor der Bot auch nur dazu kommt, die robots.txt-Datei zu lesen. Dann bekommt der Bot die Seite gar nicht, egal wie gut dein Inhalt ist.
Viele CDN- und Sicherheitsdienste haben begonnen, bekannte KI-Bots standardmäßig oder mit einem Klick zu blockieren. Das kann eine bewusste Entscheidung sein, aber oft ist es versehentlich aktiv geblieben oder von jemand anderem eingerichtet worden. Das Ergebnis ist, dass ein menschlicher Besucher und Googlebot auf die Seite kommen, aber zum Beispiel ClaudeBot als Antwort eine Sperre bekommt.
In einem realen Beispielfall kam ChatGPT auf die Website, aber Claude von Anthropic war in der Firewall des Servers blockiert. Für den Nutzer sieht das so aus, dass der eine KI-Assistent über das Unternehmen Auskunft geben kann und der andere nichts dazu findet. Ein gewöhnliches SEO-Tool deckt das Problem nicht auf, weil es nur die robots.txt-Datei liest, in der die Sperre nicht auftaucht: Die Sperre geschieht viel früher auf Netzwerkebene.
Robots.txt hält nicht immer
Eine weitere überraschende Sache ist, dass robots.txt nicht für alle Bots verbindlich ist. Bots, die auf Nutzeranfrage unterwegs sind, umgehen Verbote oft. OpenAI hat selbst festgestellt, dass die robots.txt-Regeln nicht unbedingt für eine ChatGPT-User-Anfrage gelten, weil ein Mensch sie auslöst.
Das ist keine reine Theorie. Branchenuntersuchungen zufolge erreichte ChatGPT-User bei rund der Hälfte jener europäischen Websites, die ihn in der robots.txt-Datei ausdrücklich blockiert hatten, dennoch Seiten. Die praktische Lehre geht in beide Richtungen: Du kannst dich nicht darauf verlassen, dass robots.txt Echtzeit-Agenten blockiert, und du kannst andererseits nicht annehmen, dass eine bloße robots.txt-Freigabe genügt, um deine Seite für die KI sichtbar zu machen. Die Sichtbarkeit entscheidet sich erst daran, ob der Bot auf die Seite kommt und ob er den Inhalt lesen kann.
JavaScript und Rendering: der wichtigste technische Punkt
Googlebot kann JavaScript ausführen und rendern, aber die meisten KI-Bots führen überhaupt kein JavaScript aus. Sie lesen nur das HTML, das der Server zurückgibt. Wenn der wichtige Inhalt erst im Browser per JavaScript hereinkommt, sieht der KI-Bot praktisch eine leere Seite.
Das ist die wichtigste technische Erkenntnis des Artikels. Laut der umfangreichen Untersuchung von Vercel und MERJ (Dezember 2024) führten GPTBot, OAI-SearchBot, ClaudeBot und PerplexityBot kein JavaScript aus. Sie laden eventuell die JavaScript-Dateien (als Teil der abgerufenen Daten), führen sie aber nicht aus, sodass Inhalt, der später per Code hinzugefügt wird, für sie verborgen bleibt. Googlebot und einige browserbasierte Agenten sind Ausnahmen, die die Seite rendern.
In der Praxis entsteht das Problem, wenn die Seite mit einem schweren Client-side-Framework gebaut wird oder wenn Preise, Produktdaten, Texte oder Schema-Daten erst über den Google Tag Manager oder ein anderes Skript in die Seite injiziert werden. Für den Menschen und für Google sieht die Seite vollständig aus, aber für den KI-Bot ist das Gerüst, das der Server zurückgibt, fast leer. Die Lösung ist, dass der Inhalt fertig im HTML steht, das der Server erzeugt, entweder serverseitig gerendert (SSR) oder als statische Seite.
Das Gerüst der Seite ist ein fast leeres <div id="root"></div>, und Überschriften, Texte und Preise erscheinen erst, wenn der Browser das JavaScript ausführt. Der KI-Bot liest nur das leere Gerüst.
Die H1-Überschrift, die Fließtexte, die Preise und application/ld+json stehen direkt im HTML, das der Server zurückgibt. Der Bot sieht denselben Inhalt wie ein Mensch, ohne JavaScript.
Wie testest du, ob die KI deine Seite sieht?
Du brauchst keine Spezialwerkzeuge. Mit drei Prüfungen siehst du schnell, ob die KI den Inhalt deiner Seite sieht.
Drei Wege, die Sichtbarkeit für die KI zu testen
- Prüfe den Quelltext. Öffne im Browser Seitenquelltext anzeigen (View Source), nicht die DOM-Ansicht der DevTools. Suche, ob die H1-Überschrift, die Fließtexte, die Preise und
application/ld+jsondirekt im HTML stehen. Wenn sie im Quelltext fehlen, fehlen sie auch für den KI-Bot. - Frag die Modelle direkt. Bitte ChatGPT, Claude und Perplexity, in Echtzeit Informationen direkt von der Adresse deiner Seite abzurufen. Schau, ob sie den Inhalt bekommen oder nicht. Wenn ein Modell nichts findet, liegt dort eine Sperre oder ein Rendering-Problem vor.
- Schau in die Server- und CDN-Logs. Prüfe in den Logs des Servers und im Verwaltungspanel des CDN (zum Beispiel in der KI-Ansicht von Cloudflare), ob die KI-Bots als Antwort 200 OK bekommen oder Sperren wie 403 oder 429. Ein Sperrcode sagt, dass der Bot schon auf Netzwerkebene abgewiesen wird.
Braucht es llms.txt und neue Wunderdateien?
Neue Zusatzdateien wie llms.txt braucht es nicht unbedingt. Die großen KI-Anbieter haben sich nicht auf sie festgelegt, und eine einzelne Datei behebt nicht, dass der Bot nicht auf die Seite kommt oder den Inhalt nicht sieht. Rund 80 Prozent des gewöhnlichen SEO gelten weiterhin.
Mit anderen Worten: Die Grundlagen tragen nach wie vor: technische Erreichbarkeit, klare Seitenstruktur, sinnvolle interne Verlinkung und Glaubwürdigkeit (E-E-A-T, also Erfahrung, Fachwissen, Autorität und Vertrauenswürdigkeit). Die größte Veränderung im KI-Zeitalter ist, dass der kritische Inhalt der Seite und die Schema-Daten direkt aus dem HTML lesbar sein müssen, ohne vom Browser ausgeführtes JavaScript, und dass die Bots auf die Seite gelassen werden müssen. Wenn das in Ordnung ist, sind gesonderte Wunderdateien höchstens Feinschliff.
| Faktor | Googlebot | Die meisten KI-Bots |
|---|---|---|
| Führt JavaScript aus | Ja, rendert die Seite | Nein, liest nur das HTML des Servers |
| Kommt meist durch die Firewall | Meist ja | Oft blockiert auf IP- oder CDN-Ebene |
| Befolgt robots.txt | Ja | Unterschiedlich, Nutzeranfrage umgeht es oft |
| Sieht nur per JS geladenen Inhalt | Ja (nach dem Rendering) | Sieht ihn nicht |
Wie Novavalo das löst
Die oben beschriebenen Probleme entstehen weitgehend daraus, wie eine Website technisch gebaut ist. Der Ansatz von Novavalo beseitigt sie von Grund auf, weil die Seiten am Server fertig erzeugt werden.
Seiten, die sowohl für Google als auch für die KI sichtbar sind
Novavalo erzeugt am Server fertig gebautes, statisches HTML, das die KI-Bots lesen können:
- Der Inhalt steht fertig im HTML. Überschriften, Texte, Preise und Schema-Daten sind schon in der Antwort des Servers enthalten, nicht erst hinter dem JavaScript.
- Keine unnötigen Bot-Sperren. Die Seiten werden über ein schnelles CDN so ausgeliefert, dass die KI-Bots genauso hereinkommen wie Google.
- Strukturierte Daten automatisch. Für jede Seite wird eine passende Schema-Auszeichnung erzeugt, die die KI lesen und zitieren kann.
- Test der GEO/AEO-Sichtbarkeit. Du kannst in klarer Sprache prüfen, wie die KI-Suche dein Unternehmen sieht, und bekommst Korrekturvorschläge.
Häufig gestellte Fragen
Warum erscheint meine Website bei Google, aber nicht in der KI-Suche?
Googlebot rendert JavaScript, und oft lassen auch Firewalls ihn durch, deshalb sieht Google die Seite. Die meisten KI-Bots führen kein JavaScript aus, sondern lesen nur das rohe HTML, das der Server zurückgibt, und sie können schon in der Firewall oder im CDN blockiert werden, bevor sie die Seite überhaupt lesen. Wenn der Inhalt erst im Browser entsteht oder der Bot blockiert ist, sieht die KI eine leere Seite.
Führen KI-Bots JavaScript aus?
Überwiegend nicht. Laut einer umfangreichen Untersuchung führen GPTBot, OAI-SearchBot, ClaudeBot und PerplexityBot kein JavaScript aus, sondern lesen nur das HTML, das der Server zurückgibt. Sie laden eventuell die JS-Dateien, führen sie aber nicht aus. Googlebot ist die Ausnahme, weil er JavaScript rendert.
Warum zeigt mein SEO-Tool Grün, obwohl die KI die Seite nicht sieht?
Gewöhnliche SEO-Tools prüfen oft nur die robots.txt-Datei und die Indexierbarkeit. Sie bemerken nicht, wenn eine Firewall oder ein CDN den KI-Bot auf IP-Ebene blockiert, und auch nicht, dass kritischer Inhalt erst per JavaScript geladen wird. Deshalb kann das Tool anzeigen, dass alles in Ordnung ist, obwohl die Seite für den KI-Bot leer oder blockiert bleibt.
Wie teste ich, ob die KI meine Seite sieht?
Öffne den Quelltext der Seite (Seitenquelltext anzeigen) und prüfe, ob die H1-Überschrift, die Fließtexte, die Preise und das application/ld+json-Schema direkt im HTML stehen. Bitte dann ChatGPT, Claude oder Perplexity, Informationen direkt von der Adresse deiner Seite abzurufen, und schau, ob es gelingt. Prüfe zuletzt in den Logs des Servers oder des CDN, ob die KI-Bots als Antwort 200 OK bekommen oder Sperren wie 403 oder 429.
Brauche ich eine llms.txt-Datei?
Nicht unbedingt. Die großen KI-Anbieter haben sich nicht auf llms.txt festgelegt, und die Datei ersetzt die Grundlagen nicht. Rund 80 Prozent des gewöhnlichen SEO gelten weiterhin: Erreichbarkeit, klare Struktur, interne Verlinkung und Glaubwürdigkeit (E-E-A-T). Die wichtigste Veränderung ist, dass kritischer Inhalt und Schema-Daten direkt aus dem HTML lesbar sein müssen, ohne JavaScript.
Sind die Seiten von Novavalo für die KI sichtbar?
Ja. Novavalo erzeugt am Server fertig gebautes, statisches HTML, in dem Überschriften, Texte, Preise und Schema-Daten ohne JavaScript-Abhängigkeit enthalten sind. Die Seiten werden über ein schnelles CDN ausgeliefert, ohne IP-Sperren gegen KI-Bots, sodass der KI-Bot denselben Inhalt sieht wie ein Mensch.
Sei auch in der KI-Suche sichtbar
Lass die KI deinem Unternehmen eine Website bauen, deren Inhalt fertig im HTML des Servers steht und die sowohl Google als auch die KI-Suche sieht. Das Ergebnis siehst du in wenigen Minuten.
Kostenlos starten →Transparenzhinweis: Dieser Artikel wurde mit Unterstützung von künstlicher Intelligenz erstellt, und die Redaktion von Novavalo verantwortet seinen Inhalt. Der Artikel ist allgemeine Information zur KI-Suche und zum technischen SEO. Bots und ihre Praktiken ändern sich schnell, prüfe aktuelle Angaben daher in den offiziellen Quellen unten.