Tekoälyhaku · Tekninen SEO
Miksi sivustosi menestyy Googlessa mutta on tekoälylle näkymätön
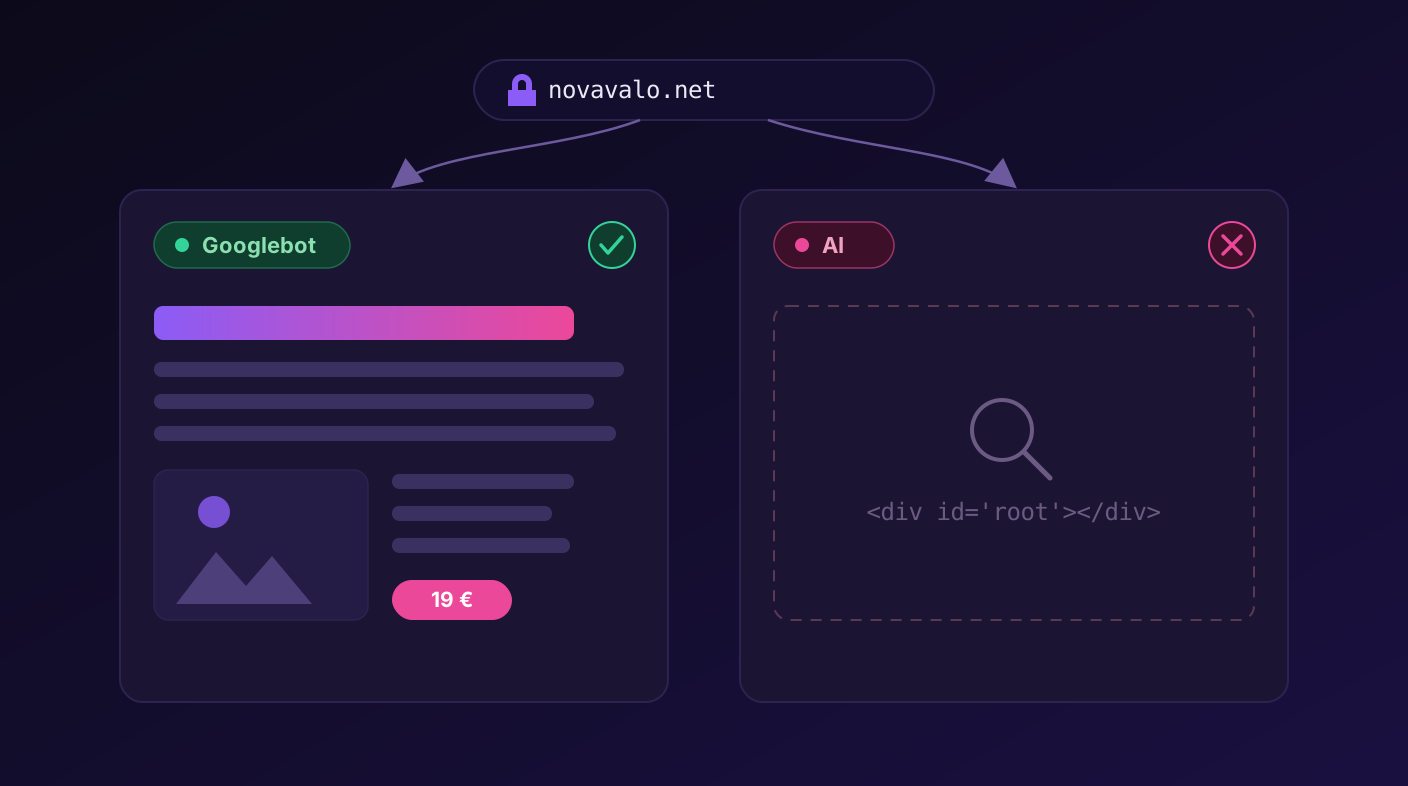
Sivustosi voi sijoittua Googlessa hyvin, saada vihreät merkinnät SEO-työkaluissa ja silti olla tekoälyhaulle ja AI-agenteille lähes näkymätön. ChatGPT, Claude, Perplexity ja Gemini eivät näe verkkoa samalla tavalla kuin Google. Tässä artikkelissa käymme läpi kolme syytä, miksi tekoäly ei näe sivuasi, miten testaat asian itse ja miksi palvelimen generoima HTML ratkaisee ongelman.
Lyhyesti: jos tärkeä sisältösi (otsikot, tekstit, hinnat, Schema-data) ladataan vasta selaimessa JavaScriptillä, moni tekoälybotti näkee tyhjän sivun. Sama koskee tilannetta, jossa palomuuri tai CDN estää AI-botin. SEO-työkalusi ei välttämättä kerro tästä mitään.
Google ja tekoälyhaku lukevat verkkoa eri tavalla. Googlebot renderöi JavaScriptin ja pääsee useimmiten palomuurien läpi. Useimmat tekoälybotit eivät aja JavaScriptiä, vaan lukevat vain palvelimen palauttaman raa'an HTML:n, ja ne voidaan estää jo palomuurissa tai CDN:ssä.
Siksi sivusto voi menestyä Googlessa mutta jäädä tekoälylle näkymättömäksi. Tavalliset SEO-työkalut eivät huomaa tätä, koska ne lukevat lähinnä robots.txt-tiedostoa eivätkä varsinaista boteille tarjoiltua sisältöä.
Ratkaisu on, että kriittinen sisältö ja Schema-data ovat valmiina palvelimen palauttamassa HTML:ssä (SSR tai staattinen sivu) eivätkä AI-botit ole estettyjä. Novavalo tuottaa juuri tällaista staattista HTML:ää, joten Novavalolla rakennetut sivut näkyvät sekä Googlelle että tekoälylle.
Eri botit eri tarkoituksiin
Tekoälyyhtiöillä ei ole yhtä bottia vaan useita erillisiä botteja eri tehtäviin: yksi kerää aineistoa mallin koulutukseen, toinen rakentaa hakuindeksiä ja kolmas hakee sivun silloin, kun käyttäjä sitä juuri pyytää. Sivustosi voi sallia yhden ja estää toisen huomaamattaan.
Esimerkiksi OpenAI ja Anthropic ajavat kumpikin useampaa bottia. OpenAIlla GPTBot kerää koulutusdataa, OAI-SearchBot rakentaa hakutuloksia ja ChatGPT-User hakee sivun käyttäjän reaaliaikaisesta pyynnöstä. Anthropicilla vastaavasti ClaudeBot kerää aineistoa, Claude-SearchBot tarkistaa sivuja hakua varten ja Claude-User noutaa sivun, kun joku kysyy Claudelta jotain kyseisestä osoitteesta.
Google on tässä poikkeus. Sillä ei ole erillistä AI-bottia samalla tavalla, vaan perinteinen Googlebot hoitaa pääosin myös AI Overview -tulosten ja tekoälyominaisuuksien taustatyön. Siksi se, mikä toimii Googlelle, ei automaattisesti toimi muille tekoälytoimijoille: Google on jo valmiiksi sisällä, kun taas erilliset AI-botit pitää päästää erikseen sisään ja niiden pitää pystyä lukemaan sivu.
Palomuurit ja CDN estävät botteja ennen robots.txt:tä
Suojauskerros, kuten Cloudflare, WAF-palomuuri tai webhotellin estoasetukset, voi torjua tekoälybotin jo IP-tasolla, ennen kuin botti ehtii edes lukea robots.txt-tiedostoa. Tällöin botti ei saa sivua lainkaan, vaikka sisältösi olisi kuinka hyvää.
Moni CDN- ja tietoturvapalvelu on alkanut estää tunnettuja AI-botteja oletuksena tai yhdellä napsautuksella. Se voi olla tietoinen valinta, mutta usein se on jäänyt päälle vahingossa tai asennettu jonkun muun toimesta. Lopputulos on, että ihmiskävijä ja Googlebot pääsevät sivulle, mutta esimerkiksi ClaudeBot saa vastaukseksi eston.
Todellisessa esimerkkitapauksessa ChatGPT pääsi sivustolle, mutta Anthropicin Claude oli estetty palvelimen palomuurissa. Käyttäjälle tämä näkyy niin, että toinen tekoälyassistentti osaa kertoa yrityksestä ja toinen ei löydä siitä mitään. Tavallinen SEO-työkalu ei paljasta ongelmaa, koska se lukee vain robots.txt-tiedostoa, jossa estoa ei näy: esto tapahtuu verkkotasolla paljon aiemmin.
Robots.txt ei aina pidä
Toinen yllättävä seikka on, että robots.txt ei ole kaikille boteille sitova. Käyttäjän pyynnöstä liikkuvat botit ohittavat kiellot usein. OpenAI on itse todennut, että koska ChatGPT-User-pyynnön käynnistää ihminen, robots.txt-säännöt eivät välttämättä päde siihen.
Tämä ei ole pelkkää teoriaa. Alan selvitysten mukaan ChatGPT-User tavoitti sivuja noin puolella niistä eurooppalaisista sivustoista, jotka olivat nimenomaisesti estäneet sen robots.txt-tiedostossa. Käytännön opetus on kaksisuuntainen: et voi luottaa siihen, että robots.txt estäisi reaaliaikaiset agentit, etkä toisaalta voi olettaa, että pelkkä robots.txt-sallinta riittäisi tekemään sivustasi tekoälylle näkyvän. Näkyvyys ratkeaa vasta siinä, pääseekö botti sivulle ja pystyykö se lukemaan sisällön.
JavaScript ja renderöinti: tärkein tekninen pointti
Googlebot osaa ajaa ja renderöidä JavaScriptiä, mutta useimmat tekoälybotit eivät suorita JavaScriptiä lainkaan. Ne lukevat vain sen HTML:n, jonka palvelin palauttaa. Jos tärkeä sisältö tuodaan vasta selaimessa JavaScriptillä, tekoälybotti näkee käytännössä tyhjän sivun.
Tämä on artikkelin tärkein tekninen havainto. Laajan Vercelin ja MERJ:n selvityksen (joulukuu 2024) mukaan GPTBot, OAI-SearchBot, ClaudeBot ja PerplexityBot eivät suorittaneet JavaScriptiä. Ne saattavat ladata JavaScript-tiedostot (osana haettua dataa), mutta eivät aja niitä, joten koodilla myöhemmin lisättävä sisältö jää niiltä piiloon. Googlebot ja jotkin selainpohjaiset agentit ovat poikkeuksia, jotka renderöivät sivun.
Käytännössä ongelma syntyy, kun sivu rakennetaan raskaalla client-side-kehyksellä tai kun hinnat, tuotetiedot, tekstit tai Schema-data injektoidaan sivulle vasta Google Tag Managerin tai muun skriptin kautta. Ihmiselle ja Googlelle sivu näyttää täydeltä, mutta tekoälybotille palvelimen palauttama runko on lähes tyhjä. Ratkaisu on, että sisältö on valmiina palvelimen generoimassa HTML:ssä, joko palvelinrenderöitynä (SSR) tai staattisena sivuna.
Sivun runko on lähes tyhjä <div id="root"></div>, ja otsikot, tekstit ja hinnat ilmestyvät vasta, kun selain ajaa JavaScriptin. Tekoälybotti lukee vain tyhjän rungon.
H1-otsikko, leipätekstit, hinnat ja application/ld+json ovat suoraan palvelimen palauttamassa HTML:ssä. Botti näkee saman sisällön kuin ihminen, ilman JavaScriptiä.
Miten testaat, näkeekö tekoäly sivusi?
Et tarvitse erikoistyökaluja. Kolmella tarkistuksella näet nopeasti, näkeekö tekoäly sivusi sisällön.
Kolme tapaa testata näkyvyys tekoälylle
- Tarkista lähdekoodi. Avaa selaimessa Näytä sivun lähdekoodi (View Source), älä DevToolsin DOM-näkymää. Etsi, löytyvätkö H1-otsikko, leipätekstit, hinnat ja
application/ld+jsonsuoraan HTML:stä. Jos ne puuttuvat lähdekoodista, ne puuttuvat myös tekoälybotilta. - Kysy malleilta suoraan. Pyydä ChatGPT:tä, Claudea ja Perplexityä hakemaan reaaliaikaisesti tietoa suoraan sivusi osoitteesta. Katso, saavatko ne sisällön vai eivät. Jos jokin malli ei löydä mitään, sillä on este tai renderöintiongelma.
- Katso palvelin- ja CDN-lokit. Tarkista palvelimen lokeista ja CDN:n hallintapaneelista (esimerkiksi Cloudflaren AI-näkymä), saavatko AI-botit vastauksena 200 OK vai estoja kuten 403 tai 429. Estokoodi kertoo, että botti torjutaan jo verkkotasolla.
Tarvitaanko llms.txt ja uusia ihmetiedostoja?
Uusia erillistiedostoja, kuten llms.txt, ei välttämättä tarvita. Suuret tekoälytoimijat eivät ole sitoutuneet niihin, eikä yksittäinen tiedosto korjaa sitä, ettei botti pääse sivulle tai ettei se näe sisältöä. Noin 80 prosenttia tavallisesta SEO:sta pätee edelleen.
Toisin sanoen perusasiat kantavat yhä: tekninen saavutettavuus, selkeä sivurakenne, järkevä sisäinen linkitys ja uskottavuus (E-E-A-T, eli kokemus, asiantuntemus, auktoriteetti ja luotettavuus). Suurin muutos tekoälyaikana on, että sivun kriittinen sisältö ja Schema-data on pystyttävä lukemaan suoraan HTML:stä ilman selaimen suorittamaa JavaScriptiä, ja että botit on päästettävä sivulle. Kun tämä on kunnossa, erilliset ihmetiedostot ovat korkeintaan hienosäätöä.
| Tekijä | Googlebot | Useimmat AI-botit |
|---|---|---|
| Suorittaa JavaScriptin | Kyllä, renderöi sivun | Ei, lukee vain palvelimen HTML:n |
| Pääsee useimmiten palomuurin läpi | Yleensä kyllä | Usein estetty IP- tai CDN-tasolla |
| Noudattaa robots.txt:tä | Kyllä | Vaihtelee, käyttäjän pyyntö ohittaa usein |
| Näkee vain JS:llä ladatun sisällön | Kyllä (renderöinnin jälkeen) | Ei näe |
Miten Novavalo ratkaisee tämän
Edellä kuvatut ongelmat syntyvät pitkälti siitä, miten sivusto on teknisesti rakennettu. Novavalon lähestymistapa poistaa ne lähtökohtaisesti, koska sivut tuotetaan palvelimella valmiiksi.
Sivut, jotka näkyvät sekä Googlelle että tekoälylle
Novavalo tuottaa palvelimella valmiiksi rakennetun staattisen HTML:n, jonka tekoälybotit osaavat lukea:
- Sisältö on valmiina HTML:ssä. Otsikot, tekstit, hinnat ja Schema-data ovat mukana jo palvelimen vastauksessa, eivät vasta JavaScriptin takana.
- Ei turhia bottiestoja. Sivut tarjoillaan nopean CDN:n kautta niin, että tekoälybotit pääsevät sisään siinä missä Googlekin.
- Rakenteinen data automaattisesti. Jokaiselle sivulle tuotetaan asianmukainen Schema-merkintä, jota tekoäly osaa lukea ja lainata.
- GEO/AEO-näkyvyyden testi. Voit tarkistaa selkokielellä, miten tekoälyhaku näkee yrityksesi, ja saada korjausehdotukset.
Usein kysytyt kysymykset
Miksi sivustoni näkyy Googlessa mutta ei tekoälyhaussa?
Googlebot renderöi JavaScriptin ja usein myös palomuurit päästävät sen läpi, joten Google näkee sivun. Useimmat tekoälybotit eivät aja JavaScriptiä, vaan lukevat vain palvelimen palauttaman raa'an HTML:n, ja ne voidaan estää palomuurissa tai CDN:ssä jo ennen sivun lukemista. Jos sisältö syntyy vasta selaimessa tai botti on estetty, tekoäly näkee tyhjän sivun.
Suorittavatko tekoälybotit JavaScriptiä?
Pääosin eivät. Laajan selvityksen mukaan GPTBot, OAI-SearchBot, ClaudeBot ja PerplexityBot eivät suorita JavaScriptiä, vaan lukevat vain palvelimen palauttaman HTML:n. Ne saattavat ladata JS-tiedostot, mutta eivät aja niitä. Googlebot on poikkeus, koska se renderöi JavaScriptin.
Miksi SEO-työkalu näyttää vihreää, vaikka tekoäly ei näe sivua?
Tavalliset SEO-työkalut tarkistavat usein vain robots.txt-tiedoston ja indeksoitavuuden. Ne eivät huomaa, jos palomuuri tai CDN estää tekoälybotin IP-tasolla, eivätkä sitä, että kriittinen sisältö ladataan vasta JavaScriptillä. Siksi työkalu voi näyttää kaiken olevan kunnossa, vaikka tekoälybotille sivu jää tyhjäksi tai estetyksi.
Miten testaan, näkeekö tekoäly sivuni?
Avaa sivun lähdekoodi (Näytä sivun lähdekoodi) ja tarkista, löytyvätkö H1-otsikko, leipätekstit, hinnat ja application/ld+json-schema suoraan HTML:stä. Pyydä sitten ChatGPT:tä, Claudea tai Perplexityä hakemaan tietoa suoraan sivusi osoitteesta ja katso onnistuuko se. Tarkista lopuksi palvelimen tai CDN:n lokeista, saavatko AI-botit vastauksena 200 OK vai estoja kuten 403 tai 429.
Tarvitsenko llms.txt-tiedoston?
Et välttämättä. Suuret tekoälytoimijat eivät ole sitoutuneet llms.txt-tiedostoon, eikä se korvaa perusasioita. Noin 80 prosenttia tavallisesta SEO:sta pätee edelleen: saavutettavuus, selkeä rakenne, sisäinen linkitys ja uskottavuus (E-E-A-T). Tärkein muutos on, että kriittinen sisältö ja Schema-data on pystyttävä lukemaan suoraan HTML:stä ilman JavaScriptiä.
Ovatko Novavalon sivut tekoälylle näkyviä?
Kyllä. Novavalo tuottaa palvelimella valmiiksi rakennetun staattisen HTML:n, jossa otsikot, tekstit, hinnat ja Schema-data ovat mukana ilman JavaScript-riippuvuutta. Sivut tarjoillaan nopean CDN:n kautta ilman tekoälybottien IP-estoja, joten tekoälybotti näkee saman sisällön kuin ihminen.
Näy myös tekoälyhaussa
Anna tekoälyn rakentaa yrityksellesi sivusto, jonka sisältö on valmiina palvelimen HTML:ssä ja jonka sekä Google että tekoälyhaku näkevät. Näet lopputuloksen muutamassa minuutissa.
Aloita ilmaiseksi →Läpinäkyvyyshuomautus: Tämä artikkeli on tuotettu tekoälyn avustuksella ja Novavalon toimitus vastaa sen sisällöstä. Artikkeli on yleistä tietoa tekoälyhausta ja teknisestä SEO:sta. Botit ja niiden käytännöt muuttuvat nopeasti, joten tarkista ajantasaiset tiedot alla olevista virallisista lähteistä.